Hosting pisze, że przekraczasz limit CPU. Strona ładuje się wolno, panel jeszcze wolniej, czasem wyskakuje błąd 503. A w Google Analytics nie przybyło ani jednego klienta.
Bardzo możliwe, że Twój serwer pracuje dla robotów. Ale nie zgaduj. Sprawdź, kto zużywa czas serwera, a nie kto robi najwięcej żądań. To dwie różne rzeczy i pokażę Ci, dlaczego.
W sierpniu 2026 analizowaliśmy sklep WooCommerce, w którym w szczytowej dobie jeden bot AI odpowiadał za 95% czasu odpowiedzi serwera (suma z analityki Cloudflare). Nie był to żaden atak. Był to zweryfikowany bot dużej firmy technologicznej, przepuszczany przez większość zabezpieczeń.
Po czym poznać, że to boty AI, a nie klienci
Objawy
- mail z hostingu o przekroczonym limicie CPU albo procesów,
- błędy 503 lub 508 (o 503 przeczytasz więcej we wpisie o błędach 500 i 503),
- wolny panel administracyjny, zwłaszcza w godzinach, gdy klienci śpią,
- skok liczby żądań w statystykach hostingu albo Cloudflare bez skoku sprzedaży i zapytań.
Dlaczego Google Analytics tego nie pokaże
Boty nie uruchamiają JavaScriptu, więc kod Analytics się u nich nie odpala. Vercel w analizie z grudnia 2024 potwierdził, że główne crawlery AI nie wykonują JavaScriptu. Dlatego w Analytics widzisz spokój, a serwer w tym czasie pracuje na pełnych obrotach. Prawdę pokażą tylko logi serwera albo statystyki Cloudflare.
To nie zawsze DDoS
Ogromna liczba żądań kojarzy się z atakiem DDoS. W naszym przypadku ze sklepu ok. 700 tysięcy żądań z sieci proxy zatrzymał Cloudflare na brzegu i zużyły one 0 sekund czasu serwera. Tej samej doby jeden „grzeczny” bot odpowiadał za 95% czasu serwera.
Które boty AI odwiedzają strony WordPress
Bot botowi nierówny. Część zbiera treści do trenowania modeli, część obsługuje wyszukiwarki AI, a część pobiera stronę, bo użytkownik poprosił o to asystenta w czacie.
| Bot | Operator | Do czego służy | Czy respektuje robots.txt |
|---|---|---|---|
| GPTBot | OpenAI | treści, które mogą trafić do trenowania | tak |
| OAI-SearchBot | OpenAI | wyszukiwanie w ChatGPT | tak |
| ChatGPT-User | OpenAI | pobranie na prośbę użytkownika | reguły „mogą nie mieć zastosowania” |
| ClaudeBot | Anthropic | trening | tak, obsługuje też Crawl-delay |
| Claude-SearchBot | Anthropic | wyszukiwanie | tak |
| Claude-User | Anthropic | pobranie na prośbę użytkownika | tak |
| PerplexityBot | Perplexity | wyniki wyszukiwania | tak |
| Perplexity-User | Perplexity | pobranie na prośbę użytkownika | „zwykle ignoruje” |
| meta-externalagent | Meta | trening modeli lub indeksowanie | tak |
| meta-externalfetcher | Meta | pobranie na prośbę użytkownika | może pominąć |
Źródła: dokumentacja OpenAI, Anthropic, Perplexity i Meta, odczyt 21.10.2026. W logach spotkasz też m.in. Bytespider, Amazonbot, Amzn-SearchBot, Applebot, CCBot i PetalBot.
Skala potrafi być duża. Według raportu Fastly za II kwartał 2025 Meta odpowiadała za 52% ruchu crawlerów AI w ich sieci, Google za 23%, a OpenAI za 20% (okres od połowy kwietnia do połowy lipca 2025). To dane z sieci Fastly, nie z pojedynczej strony.
W tym wpisie blokujemy za obciążenie, nie za poglądy. Czy chcesz, żeby Twoje treści trafiały do trenowania modeli, to osobna decyzja i osobny temat.
Czego nie ruszać
- Googlebot i bingbot. Bez nich znikasz z wyszukiwarek.
- facebookexternalhit. Robi podglądy linków udostępnianych na Facebooku.
- meta-externalads. Bot reklam Meta. Jeśli prowadzisz kampanie, potrzebujesz go.
- Monitoring strony (na przykład WP Umbrella albo inny, którego używasz).
Uwaga na jeden mit: blokada tokenu Google-Extended nie zmniejszy obciążenia. Google wyjaśnia, że Google-Extended nie ma osobnego user-agenta. Stronę i tak pobiera Googlebot.
Jak sprawdzić boty w logach serwera
Gdzie znaleźć access log
Logi dostępu (access log) znajdziesz w panelu hostingu: w cPanel zwykle jako „Raw Access”, w DirectAdmin w sekcji logów domeny, a przy dostępie SSH w katalogu logów serwera. To nie jest plik debug.log WordPressa. Ten zapisuje błędy PHP i opisałem go we wpisie o trybie debugowania.
Jedna uwaga: adresy IP w logach to dane osobowe. Nie wklejaj logów do publicznych narzędzi ani do czatu z AI bez usunięcia adresów. Zanim wyślesz logi do analizy komuś z zewnątrz, zanonimizuj w nich adresy IP.
Polecenia poniżej tylko czytają plik. Formaty logów różnią się między hostingami, więc sprawdź wynik na jednej linii, zanim zaufasz liczbom.
Ile żądań robi każdy bot
awk -F'"' '{ua=tolower($6); if (match(ua, /gptbot|oai-searchbot|chatgpt-user|claudebot|claude-user|claude-searchbot|perplexitybot|perplexity-user|meta-externalagent|meta-externalfetcher|bytespider|amazonbot|amzn-searchbot|applebot|ccbot|petalbot|tiktokspider/)) print substr(ua, RSTART, RLENGTH)}' access.log \
  | sort | uniq -c | sort -rn
Polecenie bierze z każdej linii tylko pole user-agenta i liczy jedno trafienie na linię. To ważne, bo user-agent GPTBota, ClaudeBota i PerplexityBota zawiera nazwę bota dwa razy (drugi raz w adresie lub mailu operatora). Zwykłe grep -o policzyłoby je podwójnie.
Dla spakowanych archiwów .gz podaj plik przez zcat (zcat access.log.gz | awk ...), a w pozostałych poleceniach zamień grep na zgrep -h. Udział w całym ruchu porównasz z liczbą wszystkich linii:
wc -l < access.log
grep -icE 'gptbot|claudebot|meta-externalagent|bytespider|amazonbot|perplexitybot' access.log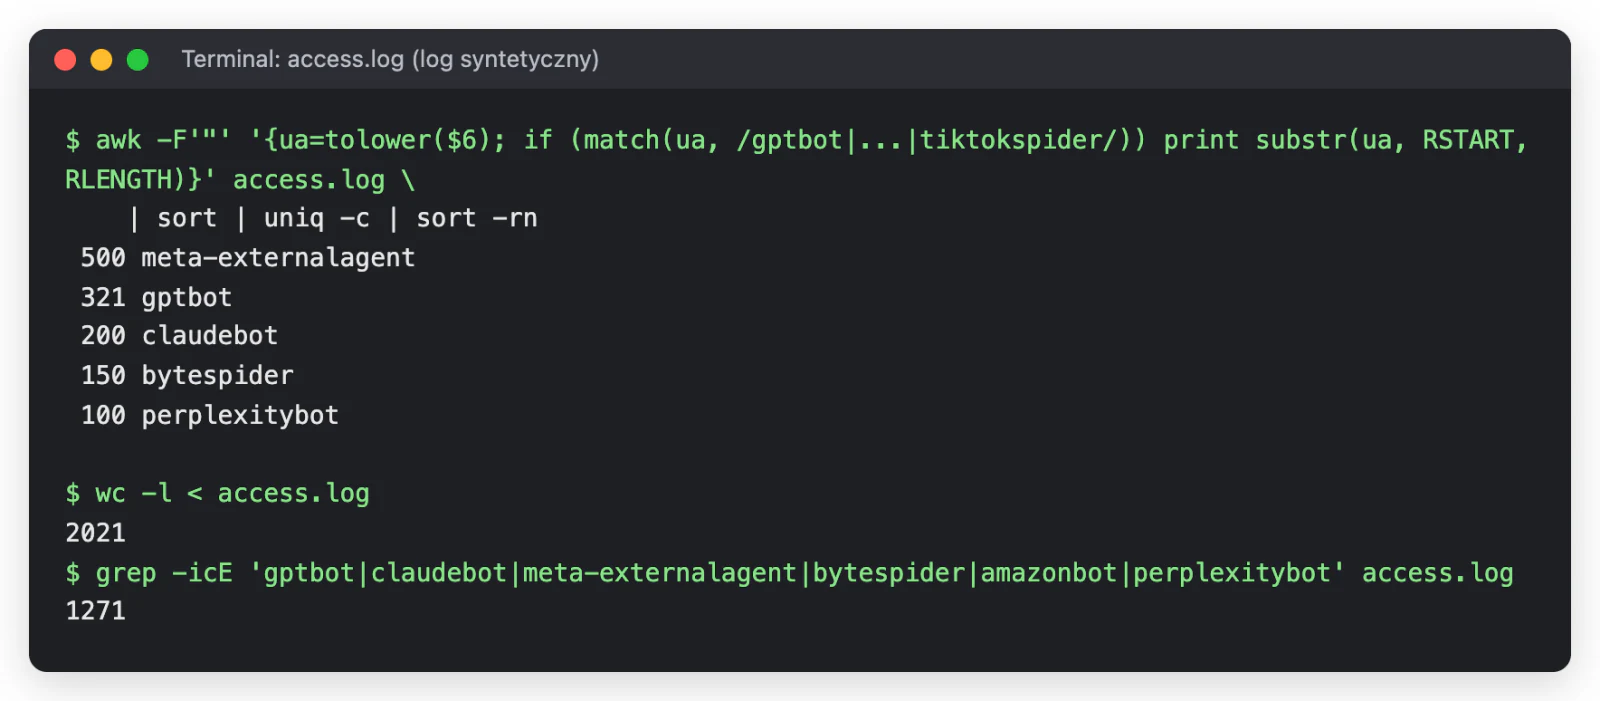
Na jakie adresy chodzi
To najważniejsze pytanie w sklepie. Boty uwielbiają filtry produktów, sortowania i wyniki wyszukiwania, bo każda kombinacja to nowy adres.
grep -i 'meta-externalagent' access.log | awk -F'"' '{split($2,r," "); print r[2]}' | sed 's/?.*//' | sort | uniq -c | sort -rn | head -20
grep -i 'meta-externalagent' access.log | awk -F'"' '{split($2,r," "); print r[2]}' | grep -c '?'
Przykład z logów tego samego sklepu z września 2026: ruch podpisany jako Amzn-SearchBot to ok. 8 600 wpisów dziennie, a 85 792 z 94 795 jego żądań w badanym okresie trafiło w adresy filtrów. Analizowaliśmy 967 941 wierszy logu.
Warto też sprawdzić kody odpowiedzi. Vercel policzył, że 34,82% pobrań ChatGPT i 34,16% pobrań Claude w ich sieci to strony 404 (u Googlebota 8,22%).
grep -i 'gptbot' access.log | awk '{print $9}' | sort | uniq -c | sort -rnCzy to prawdziwy bot
User-agent może wpisać każdy. Operatorzy publikują listy adresów IP swoich botów, na przykład OpenAI w pliku gptbot.json. Porównujesz adresy z logu z listą:
curl -s https://openai.com/gptbot.json -o gptbot.json
grep -i 'gptbot' access.log | awk '{print $1}' | sort -u > ip-gptbot.txt
python3 - <<'EOF'
import json, ipaddress
nets = [ipaddress.ip_network(p.get('ipv4Prefix') or p.get('ipv6Prefix')) for p in json.load(open('gptbot.json'))['prefixes']]
for ip in open('ip-gptbot.txt'):
    a = ipaddress.ip_address(ip.strip())
    print(ip.strip(), 'OK' if any(a in n for n in nets) else 'POZA LISTĄ')
EOF
Jeśli strona stoi za Cloudflare, w logu serwera możesz widzieć adresy Cloudflare zamiast adresu bota. Wtedy sprawdzaj w panelu Cloudflare, który oznacza zweryfikowane boty.
Liczba żądań to nie obciążenie
Tu jest sedno. Żądanie, które Cloudflare zatrzymał albo które trafiło w cache, kosztuje serwer prawie nic. Żądanie na stronę filtrów bez cache uruchamia PHP i bazę danych.
W tym wpisie „czas serwera” to suma czasów odpowiedzi serwera dla żądań danej grupy ruchu. To nie jest bezpośredni pomiar CPU, ale dobrze pokazuje, kto zajmuje serwer. Jeśli Twój log zapisuje czas obsługi (w Apache pole %D, w nginx $request_time), zsumuj ten czas osobno dla botów i dla reszty. Jeśli nie zapisuje, użyj czasu odpowiedzi serwera w analityce Cloudflare albo statystyk CPU w panelu hostingu.
Jak sprawdzić boty AI w Cloudflare
AI Crawl Control
AI Crawl Control jest dostępne na wszystkich planach, także darmowym. Pokazuje, które crawlery AI odwiedzają stronę, ile razy, jakie kody odpowiedzi dostają i które łamią zasady z robots.txt. Tam też jednym kliknięciem zezwalasz albo blokujesz konkretnego bota.
Pułapki w statystykach
W szczytowej dobie sklepu (18.08.2026) panel pokazał 3 702 645 żądań. Wyglądało to na atak. Tymczasem 1 799 358 z nich, czyli 49%, to były wpisy techniczne mechanizmu Early Hints z kodem 504, które w ogóle nie docierały do serwera.
Druga pułapka: ruch zatrzymany na brzegu (challenge, blokada) wygląda groźnie w liczbach, ale nie obciąża serwera.
Czas serwera według źródła ruchu
To jedno zestawienie pokazało winowajcę. Bot meta-externalagent zrobił 18.08 174 325 żądań, a suma czasów odpowiedzi serwera dla nich wyniosła 167 173 sekundy. To ok. 46 godzin w jednej dobie (serwer obsługuje żądania równolegle) i 95% sumy czasu odpowiedzi serwera tego dnia (167 173 z 175 984 s). Chodził głównie po filtrach produktów. W dobie 23/24.08 zrobił już 347 060 żądań.
Najpierw cache, potem blokady
Dlaczego bot na stronie bez cache jest drogi
Każde wejście bez cache to uruchomienie PHP, zapytania do bazy i złożenie strony od zera. Gdy bot wchodzi na setki tysięcy adresów, których nikt wcześniej nie oglądał, serwer liczy każdą od nowa.
Typowe dziury w cache
W naszym sklepie trafienia w cache wynosiły 5%. Przyczyna: sesja PHP zakładana dla każdego gościa, przez co prawie żadna strona nie mogła trafić do pamięci podręcznej. Inne typowe dziury to parametry filtrów i sortowań w adresach oraz wyszukiwarka sklepu.
Po naprawie cache i reguł trafienia wzrosły do 82,6%. Więcej o przyspieszaniu znajdziesz w poradniku jak przyspieszyć stronę na WordPressie.
Jak ograniczyć boty AI, od najprostszego
robots.txt - pierwszy krok, nie blokada
Plik robots.txt działa tylko na boty, które go czytają, i z opóźnieniem. OpenAI i Meta podają do 24 godzin. Boty pobierające stronę na prośbę użytkownika mogą go pominąć.
Przykład dla sklepu:
# Boty, które obciążają serwer, a nie przynoszą ruchu
User-agent: Bytespider
User-agent: meta-externalagent
Disallow: /

# Boty AI bez filtrów, sortowań i koszyka
User-agent: GPTBot
User-agent: PerplexityBot
User-agent: Amazonbot
Disallow: /*?*filter_
Disallow: /*?*orderby=
Disallow: /*?*add-to-cart=
Disallow: /koszyk/
Disallow: /zamowienie/

# ClaudeBot: te same zakazy plus spowolnienie (Anthropic obsługuje Crawl-delay)
User-agent: ClaudeBot
Crawl-delay: 5
Disallow: /*?*filter_
Disallow: /*?*orderby=
Disallow: /*?*add-to-cart=
Disallow: /koszyk/
Disallow: /zamowienie/
Dwie pułapki. Nazwy parametrów filtrów zależą od wtyczki, więc sprawdź je w swoich adresach. To samo dotyczy ścieżek: polskie tłumaczenie WooCommerce zakłada strony o adresach koszyk i zamówienie, więc zamówienie może mieć w adresie polską literę (w robots.txt zapisaną jako /zam%C3%B3wienie/). Wpisz to, co widzisz w swoich adresach. I bot stosuje tylko jedną, najlepiej pasującą do niego grupę. Dlatego ClaudeBot ma swoją grupę z kompletem zakazów, a nie jest dopisany do dwóch.
Cloudflare AI Crawl Control
Blokada jednym kliknięciem przy wybranym bocie. Cloudflare robi to przez jedną regułę WAF, którą dodaje na końcu istniejących reguł. Jeśli wyżej masz regułę „przepuść” (Skip), przekierowanie albo transformację, mogą ją obejść. Cloudflare sam zaleca przeniesienie jej na górę.
W sklepie zablokowaliśmy w ten sposób listę: meta-externalagent, Amazonbot, Applebot, DuckAssistBot, FacebookBot, PetalBot i TikTokSpider. W pierwszych 5 godzinach reguła zatrzymała ok. 24 000 żądań.
Własna reguła WAF dla konkretnego bota
W Cloudflare: Security, Security rules, Custom rules, akcja Block, pozycja pierwsza na liście.
(lower(http.user_agent) contains "meta-externalagent")
or (lower(http.user_agent) contains "bytespider")
or (lower(http.user_agent) contains "petalbot")
Wariant łagodniejszy: boty mogą czytać stronę, ale nie filtry i wyszukiwarkę.
(lower(http.user_agent) contains "gptbot" or lower(http.user_agent) contains "claudebot" or lower(http.user_agent) contains "amazonbot")
and (http.request.uri.query contains "filter_" or http.request.uri.query contains "orderby=" or any(http.request.uri.args.names[*] == "s"))
Limit tempa na planie Free
Na planie Free masz jedną regułę limitu tempa, z wyrażeniem tylko po ścieżce i oknem 10 sekund. Pole User-Agent w limicie tempa pojawia się dopiero w planie Business. Czyli na Free i Pro bota po nazwie tylko blokujesz albo weryfikujesz, nie spowalniasz.
Ostrożnie z limitem na admin-ajax.php i endpoint piksela Meta. W sklepie po wyłączeniu botów to były najdroższe ścieżki, ale limit na nie łatwo zepsuje koszyk albo śledzenie konwersji.
Jeszcze jedna uwaga: Bot Fight Mode w planie Free potrafi odbijać admin-ajax.php i wp-json, a nie da się go pominąć regułą Skip. Na formularze lepiej sprawdza się Turnstile.
Bez Cloudflare - .htaccess na LiteSpeed i Apache
Na górze pliku .htaccess, przed blokiem WordPressa:
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} (Bytespider|meta-externalagent|PetalBot) [NC]
RewriteRule .* - [F,L]
</IfModule>
Żądanie nadal dociera do serwera, ale nie uruchamia PHP. Na brzegu, w Cloudflare, jest taniej. LiteSpeed ma też własne mechanizmy: ochronę reCAPTCHA zależną od obciążenia i ograniczenia na klienta. Ustawia je administrator serwera, na hostingu współdzielonym zwykle hosting.
Wtyczki blokujące boty działają dopiero po uruchomieniu WordPressa. Moim zdaniem to najsłabsza warstwa, bo każde żądanie i tak kosztuje PHP.
Kiedy pisać do hostingu
Gdy nie masz dostępu do logów, gdy obciążenie nie spada mimo blokad albo gdy limity są za ciasne na Twój ruch. Poproś o access log z ostatnich dni i o informację, czy hosting sam ogranicza jakieś boty. Jeśli limity są stałym problemem, przeczytaj, jaki hosting wybrać dla WordPressa.
Kolejność reguł i inne pułapki
Reguła „przepuść boty” nad blokadą wyłącza blokadę
W sklepie ktoś przesunął regułę Skip „przepuść zweryfikowane boty” nad regułę blokującą. Przez ok. godzinę blokada nie działała, a meta-externalagent znów dostawał odpowiedź 200. Zasada, której trzymamy się od tamtej pory: najpierw blokuj złe, potem przepuszczaj dobre, na końcu weryfikuj resztę.
Warunek „lub” na końcu reguły może zablokować cały świat
Reguła ratunkowa miała warunek w stylu „bot X lub adres inny niż ten jeden”. Ten drugi warunek pasował do prawie wszystkiego. Efekt: 168 tysięcy bramek w ciągu doby dla ludzi z USA i spadek odsłon z ok. 4 600 do 1 700 na dobę. Reguły z „lub” czytaj od końca.
Blokada „treningu” w Cloudflare a Googlebot
Cloudflare zapowiedział, że od 15.09.2026 każda blokada kategorii Training (także starsze ustawienie „Block AI bots”) obejmuje crawlery mieszane, które łączą wyszukiwanie z treningiem. W zapowiedzi wymienił Googlebota, Applebota i BingBota. Dokumentacja (stan na 21.10.2026) mówi o crawlerach mieszanych bez nazw i dodaje, że nowe domeny dostają domyślnie blokadę Training i Agent na stronach z reklamami. Nie znalazłem komunikatu Cloudflare, który potwierdza, jak to działa po tej dacie, i nie sprawdziłem tego na żywej strefie. Jeśli masz to ustawienie włączone, zajrzyj do statystyk indeksowania w Google Search Console.
Testuj z innego kraju niż własny
Test z polskiego adresu IP dawał odpowiedź 200, a klient z USA dostawał bramkę. Reguły WAF bywają zależne od kraju, więc testuj z serwera albo VPN poza Polską.
Jak sprawdzić, że pomogło
Test curl z user-agentem bota i przeglądarki
curl -s -o /dev/null -w '%{http_code}\n' -A 'Mozilla/5.0 (compatible; meta-externalagent/1.1)' https://twojadomena.pl/
curl -s -o /dev/null -w '%{http_code}\n' -A 'Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)' https://twojadomena.pl/
curl -s -o /dev/null -w '%{http_code}\n' -A 'Mozilla/5.0 (Macintosh; Intel Mac OS X 14_0) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130 Safari/537.36' https://twojadomena.pl/
Oczekujesz 403 dla blokowanego bota i 200 dla Googlebota oraz przeglądarki. Uwaga: podrobiony Googlebot z Twojego IP może zostać potraktowany inaczej niż prawdziwy, bo Cloudflare weryfikuje boty po adresie. Ten test sprawdza regułę, a nie zachowanie wobec prawdziwego Googlebota. To drugie zobaczysz w Search Console.
Czas serwera - ludzie i boty, przed i po
W pomiarze sklepu z 24.08, przed zmianami, boty zużyły 6 473 sekundy czasu serwera, a ludzie 404, czyli 16 razy więcej czasu serwera szło na boty niż na ludzi. Po naprawie cache i reguł, w oknie 22 godzin, ludzie zużyli 2 854 sekundy, a zweryfikowane boty 1 055. Okna pomiaru nie są równe, więc porównuj proporcję, nie sumy. Odsłony wzrosły z 1 881 (23.08) do 3 533 (25.08), o 88%, choć żądań było o 28% mniej. Na ten wzrost wpłynęło też zdjęcie błędnej reguły, która blokowała ludzi z USA (opisanej wyżej), więc nie przypisujemy go samym zmianom w cache i blokadom botów.
Statystyki indeksowania i alert
Po każdej blokadzie przez kilka dni zaglądaj do raportu „Statystyki indeksowania” w Search Console. Spadek pobrań przez Googlebota to sygnał, że reguła łapie nie tych, co trzeba. Ustaw też alert w monitoringu, żeby wiedzieć o kolejnym skoku zanim napisze hosting.
Jak my z tym pracujemy
Do wydajności wchodzimy od pomiaru, nie od włączania opcji. Na start PageSpeed Insights, do konkretów WebPageTest i Query Monitor, bo pokazują, co dzieje się w środku. Przy botach dochodzi do tego analityka Cloudflare i logi serwera, bo tylko tam widać czas serwera.
Kolejność jest zawsze ta sama, od najtańszego i najbezpieczniejszego:
- Podstawy. Cache, grafiki, fonty, usunięcie skryptów, które ładują się tam, gdzie nie są potrzebne.
- Zaawansowane. Optymalizacja ładowania skryptów. Tu zaczyna się ryzyko dla funkcji strony.
- W ostateczności CDN i płatne usługi.
Ochronę opieramy na tych samych warstwach na każdej stronie: hardening WordPressa, Cloudflare i hosting z własnym WAF-em, a pod spodem kopie zapasowe i aktualizacje. Firewalla na poziomie WordPressa nie używamy, bo działa dopiero wtedy, gdy ruch dotarł do serwera i PHP.
Sklep a wizytówka. Na blogu i wizytówce zwykle wystarczają podstawy. W sklepie problem siedzi najczęściej w koszyku, zamówieniu i dodawaniu do koszyka, więc tam szukamy powolnych zapytań do bazy. Bardzo często największy skok daje zmiana serwera.
Po każdej zmianie klikamy ręcznie kluczowe akcje: dodanie do koszyka, koszyk, usuwanie produktów, formularz (z kontrolą, czy dane doszły), zamówienie. Każdą jako zalogowany, niezalogowany i w trybie incognito.
Kiedy nasze podejście nie jest dla Ciebie. Gdy problemem jest słaby serwer albo ciężki builder, ani CDN, ani blokady botów tego nie naprawią. Zamaskują problem. Najpierw hosting i sposób zbudowania strony.
FAQ
Czy robots.txt wystarczy, żeby boty AI przestały obciążać serwer?
Tylko dla botów, które go czytają, i z opóźnieniem do ok. 24 godzin. Boty pobierające stronę na prośbę użytkownika mogą go pomijać. Na bota, który ignoruje robots.txt, potrzebujesz reguły w Cloudflare albo na serwerze.
Czy blokada GPTBota usunie moją stronę z ChatGPT?
Według OpenAI wyszukiwaniem w ChatGPT zajmuje się OAI-SearchBot, a GPTBot dotyczy treści do trenowania. To dwa osobne boty i osobne decyzje.
Czy blokada Google-Extended odciąży serwer?
Nie. Google-Extended nie ma własnego user-agenta, stronę pobiera Googlebot.
Skąd mam wiedzieć, że to prawdziwy bot, a nie podszywający się scraper?
Porównaj adresy IP z listą operatora albo sprawdź w Cloudflare, czy bot ma status zweryfikowanego.
To atak DDoS czy bot AI?
Sprawdź, ile czasu serwera zużywa dana grupa ruchu. W opisanym sklepie w szczytowej dobie setki tysięcy żądań z sieci proxy zużyły 0 sekund, a jeden bot 95% czasu serwera.
Czy Cloudflare Free wystarczy?
Na start tak. AI Crawl Control i reguły własne są na każdym planie. Limit tempa na Free to jedna reguła i tylko po ścieżce.
Czy zablokowanie „treningu” w Cloudflare może zaszkodzić SEO?
Może. Według zapowiedzi Cloudflare od 15.09.2026 blokada Training obejmuje też crawlery mieszane, w tym Googlebota i Binga. Sprawdź ustawienia i statystyki indeksowania w Search Console.
Mam hosting bez dostępu do logów. Co wtedy?
Poproś hosting o access log z ostatnich dni albo korzystaj ze statystyk Cloudflare.
Podsumowanie
- Licz czas serwera, nie żądania.
- Najpierw cache, potem blokady.
- Reguły z „lub” czytaj od końca, a blokady stawiaj nad regułami przepuszczającymi.
- Po każdej zmianie testuj z innego kraju i ustaw alert.
Nie masz czasu grzebać w logach i regułach Cloudflare? Pilnowanie wydajności, kopii i zabezpieczeń to część naszej opieki nad stroną. Jeśli strona już działa podejrzanie, zobacz też odwirusowanie WordPressa.